张家炜 Jiawei Zhang

清华大学电子工程系 · 博士生 · 导师:谷源涛教授
2019–2023 清华本科 · 2023 年起攻读博士

研究关注高效视觉生成。在学校主要做逆问题和随机优化,偏数学和理论分析。两段实习都在做扩散模型的步数蒸馏:在腾讯混元做图像编辑,在 Ant Research 做一步图像生成。

01

研究经历:逆问题与随机优化

学校里的研究以数学建模、算法设计与理论分析为主:既研究如何利用生成先验求解问题,也研究优化算法本身的行为与收敛条件。

逆问题:从不完整观测恢复信息

面对模糊、缺损或低分辨率的图像,研究如何结合观测与扩散模型先验,得到更可靠的重建。围绕重建质量、计算效率和输出目标,形成了一条连续的研究主线。
  1. NeurIPS
    2024
    ProjDiff · 设计求解方法

    更充分地利用扩散模型的去噪能力,处理带噪观测下的重建。

  2. NeurIPS
    2025
    LLE · 改善少步推理

    复用历史估计,在有限的采样步数下改善重建质量。

  3. ICML
    2026
    MAP-RPS · 控制重建目标

    研究像素误差与感知质量的取舍,使重建结果能够按需求调节。

随机优化:步长与动量的收敛分析

研究随机梯度方法中的自适应步长与动量机制:如何根据优化过程调整更新幅度,以及这类方法在什么条件下能够稳定收敛。

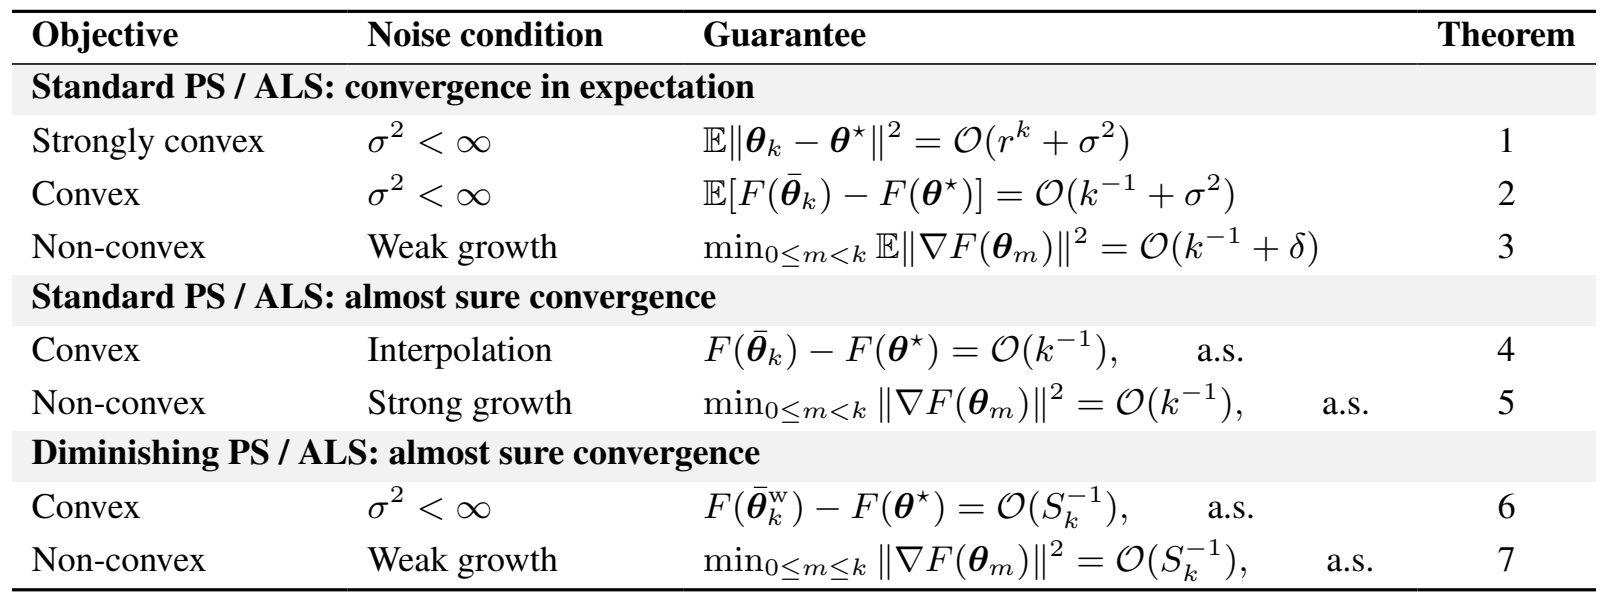
论文 Table 1:强凸、凸和非凸目标下,使用 Polyak 步长和 Armijo 线搜索的随机重球方法的收敛结果,包含定理 1 至 7。

Adaptive Polyak Step-Size for Momentum Accelerated Stochastic Gradient Descent with General Convergence Guarantee
IEEE Transactions on Signal Processing · 第一作者

Stochastic Heavy Ball with Polyak Step Size and Armijo Line Search: A General Convergence Analysis
arXiv · 第一作者

02

实习经历:扩散模型蒸馏

如何减少扩散模型的生成步数,同时尽量保留编辑能力和生成质量。

步数蒸馏:减少生成步数,加速推理

多步教师多次调用模型
噪声 模型 模型 模型图像
蒸馏训练
少步 / 一步学生更少的模型调用
噪声学生模型图像
腾讯混元2025.06–2025.08Research Intern

图像编辑的少步蒸馏

基于 FLUX Kontext,研究高效图像编辑,探索 Consistency Models 与 DMD2 的蒸馏训练与评估。

Ant Research2025.12 起Research Intern

基于 RAE 的一步图像生成

在表征自编码器(RAE)的潜空间中开展 Diffusion Transformer 蒸馏,形成 Drift-RAE 工作。

代表工作 · 第一作者 · arXiv

Drift-RAE

Distilling Drifting Transformers with Representation Autoencoders

Jiawei Zhang, Mengfei Xia, Gen Li, Yuantao Gu

研究问题

RAE 提供了语义信息丰富的生成空间,但现有多步模型的能力不容易直接压缩成一步。我们希望在这一空间里实现高质量的一步生成。

主要思路

从分析 RAE 的表征几何出发,用 Drifting 直接匹配生成样本与真实数据的分布,训练模型一次输出生成结果。

  1. 选择适合表征空间的蒸馏方式。利用样本之间的吸引与排斥,使生成分布逐渐接近数据分布。
  2. 改进训练稳定性与分布估计。围绕扰动、样本组织和训练目标进行设计与验证。
  3. 利用模型内部信息进一步改善质量。提出 Internal Drifting Guidance,在保持一次主干前向的同时进行引导。
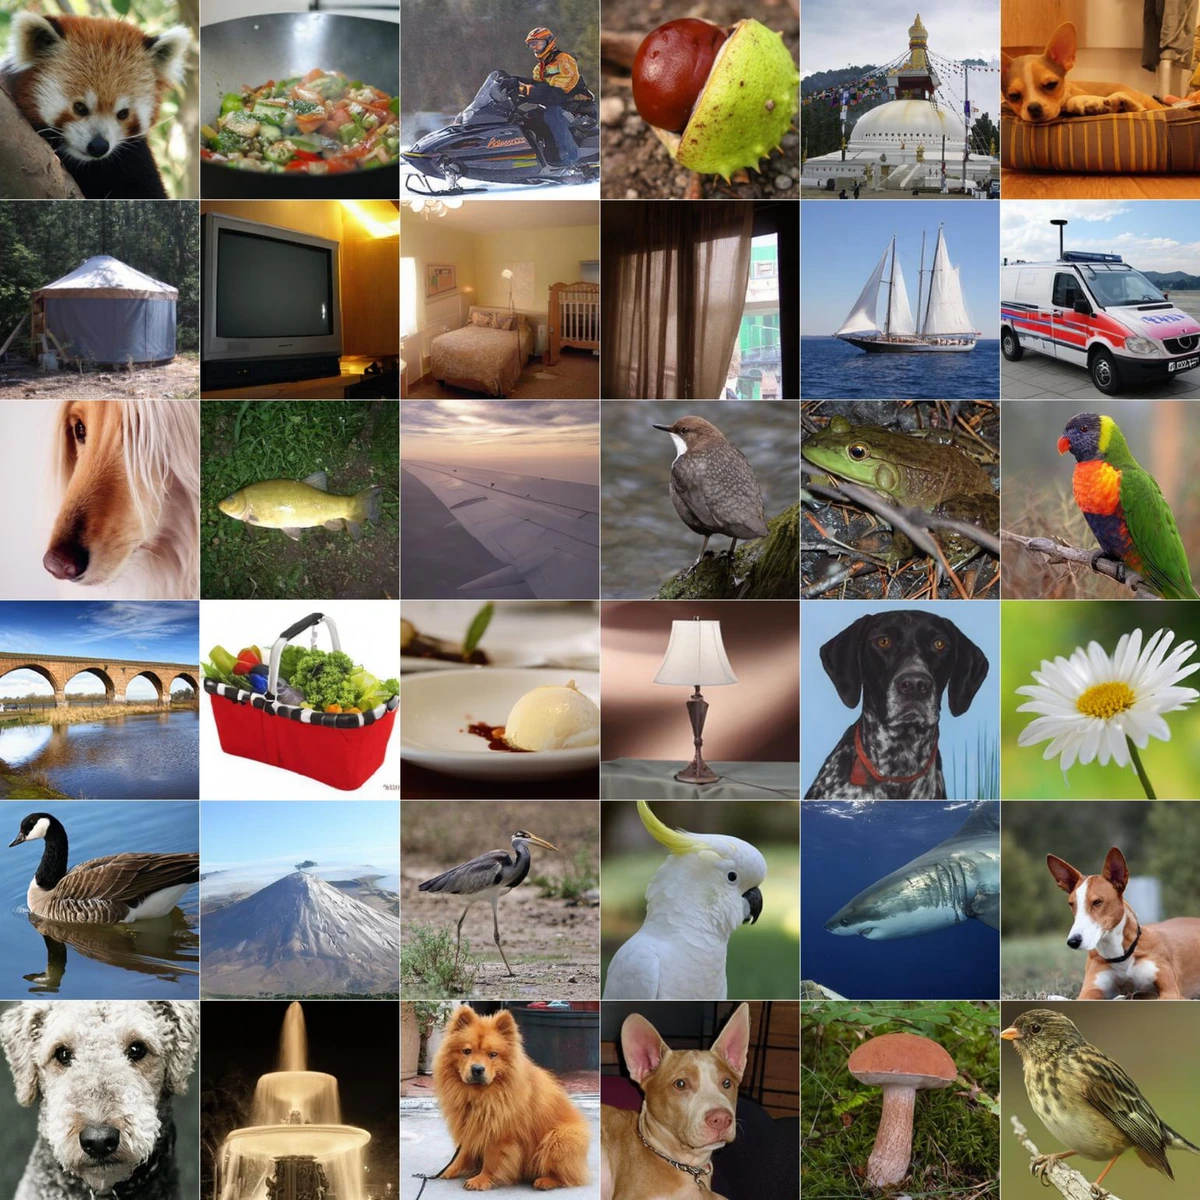
Drift-RAE 论文 Figure 2 中的一步生成结果,包含动物、物品、食物与自然场景。
论文真实生成样本 · Figure 2
ImageNet 256 × 256 类别条件生成 · DiTᴰᴴ-XL
50 × 2 → 1 NFE从多步教师到一步生成器
生成主干的调用次数
1.48 FID ↓ImageNet 256 × 256
生成分布质量指标,越低越好
16 epochs从预训练模型初始化
蒸馏阶段的训练轮数

结果采用 DiTᴰᴴ-XL + IDG。预训练教师为 50 × 2 NFE、FID 1.13;一步模型为 1 NFE、FID 1.48。

03

研究兴趣:高效图像与视频生成

希望继续围绕生成模型的效率与质量开展研究:近期关注蒸馏与强化学习的结合,长远探索结构信息如何帮助视频生成与蒸馏。

近期方向蒸馏 + GRPO

改善少步生成模型的随机采样与优化

关注的问题:用 GRPO 优化少步生成模型时,需要采样多个候选结果进行组内比较。采样引入的随机性,以及模型更新后的分布变化,可能使训练采样与实际推理出现差异。

研究想法:DMD 蒸馏本身会维护一个追踪生成分布的辅助模型。希望研究能否复用它提供的 score 信息,改善 GRPO 的随机 rollout,使采样方向更好地适应更新中的模型。

预期价值:在有限步数与计算预算下,改善联合训练的采样质量和稳定性,并验证收益能否体现在最终生成结果上。

长远方向视频蒸馏 + 三维结构

在加速视频生成时保留空间与运动一致性

关注的问题:视频模型在减少生成步数后,能否保持跨帧的场景结构、物体形态与运动一致性?

研究想法:探索在蒸馏中显式利用深度、相机几何和跨帧轨迹等信息。先从可测量的几何一致性入手,再逐步考虑动态物体与更明确的物理约束。

长期目标:让少步视频生成在提升效率的同时,更好地保持时空结构与运动合理性。当前重点是明确任务、约束与评估方式。